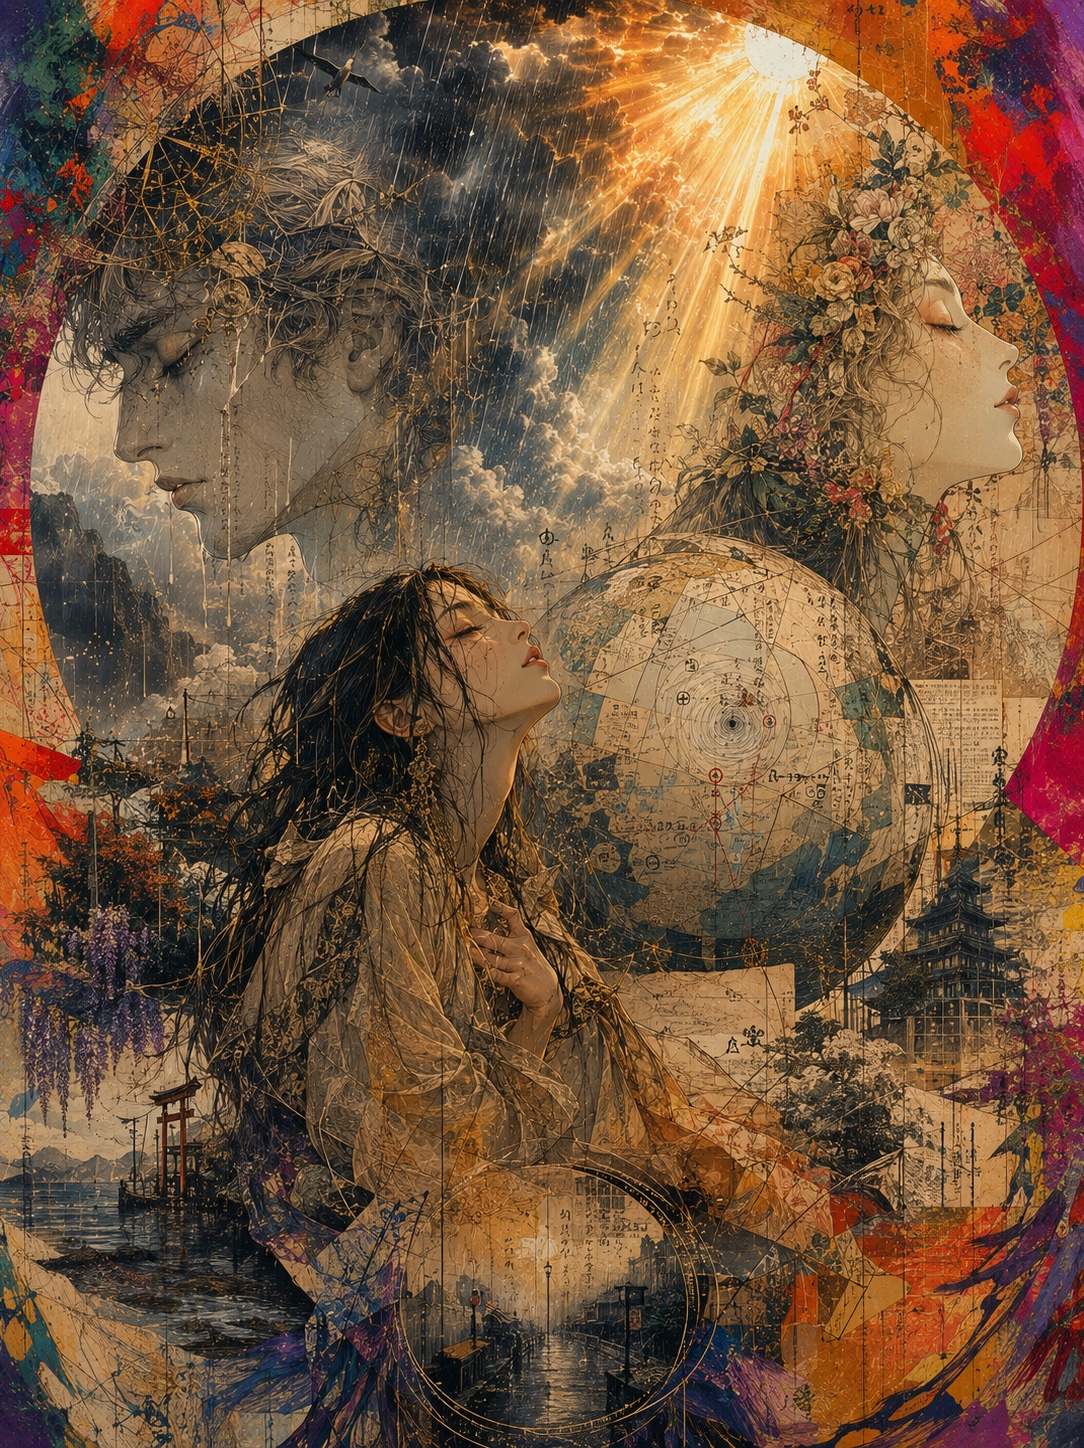
DJ KNEK RAIN -天雨地蒸- EX STEAM ♯RRD #RoughneckRainDance

DJ KNEK RAIN -天雨地蒸- EX STEAM すっかり梅雨明けしたので、DJ KNEKさんの雨景色☔️企画も終わりが近いのかな? 今回の手法も実験中のスペクトログラムロールによる音源加工とSUNOでの均質化プロセス構築がメイン マッシュアップのベースにしたのは、「水音変換」と「神社・峠道・山頂」の2曲をスペクトログラム処理したもの。2曲とも全ての音程をロールさせたかったが、水音変換はSUNOの誤認で版権曲とされたので、仕方なく水音変換の方は低音程を処理から外した音源を使用している もはや何が生成されるのかわからない状態だけど、このプロセスは古典的なアルゴリズム音楽と現代のアルゴリズム音楽であるAI音楽を統一プロセスへと再構築してると言える。その2つのアルゴリズムは1つは人である私が設計し、AI側はブラックボックスだね まず、曲として何の表現をテーマにしたかというと「蒸発」 生成された曲を聴くと... 「天空の男神、我が手の届かぬ地母神に恋焦がれ泣く梅雨景色、涙を慈しみ育てる地母神の無限の愛、天空の男神は地母神の愛に包まれる命に灼熱の嫉妬を浴びせる夏の到来、涙は蒸発し天に帰る」 という物語。まぁ後付だけど😂 📝実験の中間レポート スペクトログラムとして、低音域から高音域まで全てシフトさせると音色の発生タイミング、ビートが全て失われる。音源は元が何であれ、左ロールでは高音程から低音程へのアルペジオが支配的になる。右ロールなら音程が下から上に変わるだけ。そしてそれをSUNOに読み込ませると、アンビエントやサウンドスケープ、ノイズのフィルタースケープというスタイルで認識する。これは目安ではあるが、この認識は生成用モデルでの解釈では無いのでまぁ参考程度 バスドラとベースの音域をロール処理から外すと、この認識が電子音楽に変わる。ハイハットの音域を外しても傾向は同じ。つまり、リズムを認識し始める。色々な組み合わせでカヴァーして生成してみると、全音域をロールさせた方はやはりリズムを1から作り直すのでSUNOらしい均質なリズムになる。でも、ジャンルによってはアルペジオがトーキングドラムようなパーカッションに変わる場合もあってめちゃくちゃ複雑なリズムに変わる事もある この辺りの動きはカヴァーかマッシュアップかでも少し傾向は異なるが、概ね似た傾向が感じられる 実験としてハーモニーとドラムの分離も試したが、この分離精度の問題で設計として意図しないノイズが交じるのでこの実験は止めた。意図しないノイズは問題の切り分けがしにくく、何をやってるのかわからなくなるので😂 あと、今の処理だと曲のセクション構造を再構築してないので、曲を終わらせることがSUNOは難しいみたい。これの解決は曲のラスト8小節程を処理済みのスペクトラムから原曲のスペクトログラムへモーフィングさせると解決するかな?🤔実験してないのでわからんが。あと、セクション解析を追加してセクション毎に処理しても良いかな。要は今は曲全体でロールしてるので、セクションの区切りが明確でないのと、音楽的な終止形の音程にならないのが問題の原因だとは思う 最後に私が実験で作った簡単なスクリプトと同じものがGeminiで生成でできる様に文書化したものをつけておく。プロセスそのものを書いてあるので無課金Geminiなら一発でスクリプトにしてくれる 一応チェックした感じだと処理としてはちゃんとコードになってた。軽微なバグもあったけど、そもそも単純なのでAIで修正も出来ると思う ChatGPTは無課金だと出力トークンが少ない関係で断られるので注意ね 📝EX PROCESS(スクリプト生成用のプロンプト) 実験的なスペクトログラム操作による音楽的な脱構築と再構築用Pythonスクリプト 目的:このスクリプトは、音楽生成AIであるSUNOのRemix機能各種に与えるための音源を実験的に作成する事を目的としている。生成AIがRemix元の音源から何を認識しどの様に新たな楽曲として生成するかを観測する為に使用する。 基本方針:アルゴリズム以外の基本的な事柄 本スクリプトでスペクトログラム操作する音源はフル尺の楽曲データとする 入力ファイルはWAVファイル形式とし、44.1Kサンプリング、モノラル化して読み込み、原曲として扱う 出力ファイルも同様もWAVファイル形式とする ファイル名はコマンドラインから与える 実験で各種パラメーターを頻繁に変更する為、スクリプト内で一括変更が容易となる様にする 複数の処理フローで様々な解析データの作成、スペクトログラム操作、音源の加工を行うため、適切に関数定義化し、メインのAudioProcess関数から、フローの流れにそって呼び出せる形にする AudioProcessではフローの流れや、位置の処理をスキップさせたり、スクリプトを頻繁に書き換えて適切なアルゴリズムとなる様に模索するので、処理の効率よりも各処理の独立性を重要視する 標準出力へ各種の処理で得た有意義な情報を簡易ログとして表示する すべての出力は単一のディレクトリ内に出力する ディレクトリは適切に区別できるネーミング規則とすること。出力ファイル名をプレフィックスしてディレクトリ名を決める。タイムスタンプは不要。各種ファイル名は何の情報のファイルか識別できれば良い 音源の分析やスペクトログラムの操作にはLibrosaライブラリの開発版を使用する Librosaを使い音源から様々な分析データを得るが、それらは全て可視化しPNG形式の画像として出力する(横軸は時間に変換しなくてよい、時間フレームのまま) 配列データの操作にNumpyを使用する 処理内容を記載するコメント文は簡素で良く英語表記で統一する 製品では無いので様々な事を想定して保険的なコードは不要 処理内容: 原曲の読み込み→CQT変換(HOP長=128, 最低音程=C1, オクターブ分割数=48, C10までの範囲をカバーする)で様々な分析で使う原曲CQTデータの作成 原曲CQTデータからOnset強度の分析データを作成 Onset強度データから原曲のテンポ推定。beat_trackとplpの両方のデータを作成 スペクトログラム操作用のロール量のテーブル作成。スペクトログラム操作の処理は「音程BIN毎にスペクトログラムをロールさせる」という内容になる。低い音程から高い音程に向かってロール量を増やしながら、ロールさせると、時間フレームに対して周波数成分が変わる。左にロールされると和音は分散和音となり、高音程から低音程へと流れる様になる。また原曲の分散和音や旋律も変わる。右にロールさせると、低音程から高音程へ流れる分散和音になる。原曲全体に対してロールするので、ロール量が大きいとセクション構造も曖昧になってゆく スペクトログラム操作用のロール量のテーブル作成では、全音程を対象とするモード、低音程のC1からC3までの範囲を除外するモード、高音程のC9から上を除外するモード、そして低音程と高音程を除外するモード。Mode0からMode3をコマンドラインオプションで切り換え可能にする。また、左ロール、右ロールも切り換える。また、2音程分のBINでロール量は同じとする。オクターブ分割数が48なので、8BIN毎にロール量がインクリメント、またはデクリメントされるイメージ スペクトログラムのロール処理。テーブルに従って原曲のCQTデータに対して各BIN毎にロールさせる。複素数のまま振幅・位相をロールさせる。この時、テーブル内のロール量が示すのは時間フレーム単位となるが、これを音楽的に16分音符単位に換算して実際にロールさせる量とする。推定したテンポとHOP長で換算。換算に使った係数や、4/4拍子の場合に最大で何小節分ロールしたかの情報をログとして出力。ロール処理後のCQTデータも中間データの状態として、プロットしておく アタック音リカバー処理。Onset強度データをMinMaxノーマライゼーションして、Onset強度に応じて原音のCQTデータを処理後のCQTデータにブレンドする。つまり、強度MAXの時間フレームは原曲のスペクトログラムになる。この処理後の状態もプロットしておく。またCQTデータは複素数なので注意すること ビート感リカバー処理。アタック感のリカバーだけでは人の耳で聴いた場合、音量のダイナミクス変化が少ないだろう事が懸念されるので、ダイナミクスもリカバーする。PLPデータをMinMaxノーマライゼーションし、ビート位置の時間フレームではスペクトログラムのパワーは変わらず、その他の時間フレームでは0.7倍にする。つまり、PLP * 0.3 + 0.7の係数を処理後のCQTデータの振幅のみに掛ける。位相はそのままとし、係数をかけた後、複素数に戻しておく。この処理後のスペクトログラムの状態もプロットしておく 最後に処理後のCQTデータをWAVファイルにする。オーバーフローしてクリッピングしないように注意
