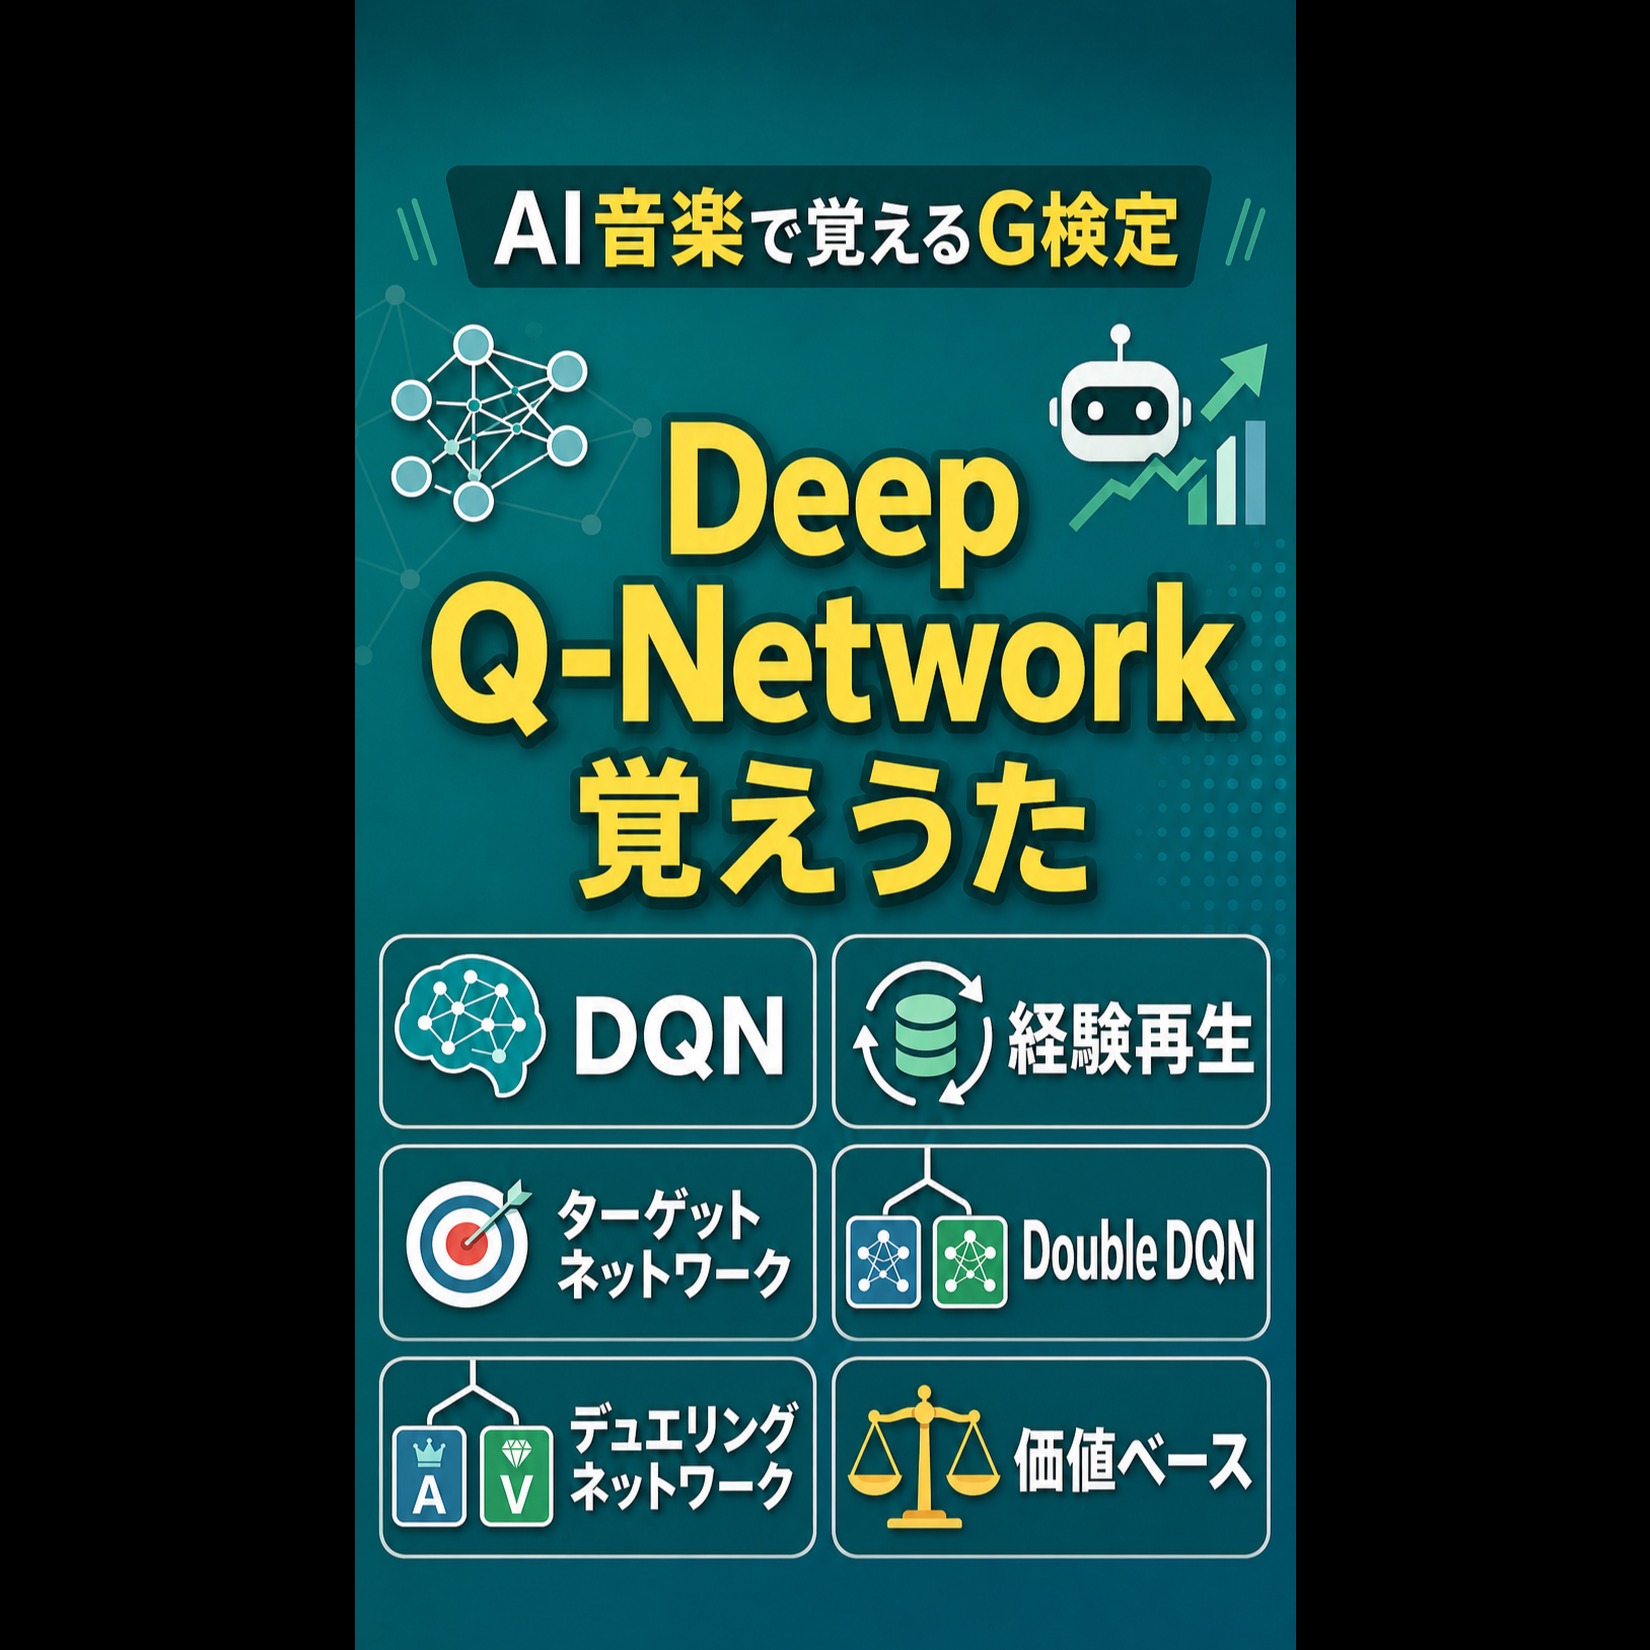
Deep Q-Network覚えうた
DQNはQ学習と ディープラーニングを 組み合わせた手法 DQNは価値ベースの 深層強化学習 経験再生は過去の経験を メモリに保存 ランダムにサンプリングして 時間的相関をなくし 学習を安定させる ターゲットネットワークは 目標値の計算に使う 重みを一定期間固定 Double DQNは Q値の過大評価を解消 行動の選択と 価値の評価を分離 デュエリングネットワークは Q値を状態価値と アドバンテージに分けて学習 Doubleは最大Q値の 行動の選択に メインネットワーク 選ばれた行動の価値の評価に ターゲットネットワーク デュエリングは すべての行動を試さなくても 状態の価値を学習 Double DQNは アルゴリズムを改良 デュエリングネットワークは ネットワーク構造を改良 DQNはQ学習に ニューラルネットワーク導入 経験再生と ターゲットネットワークで安定
