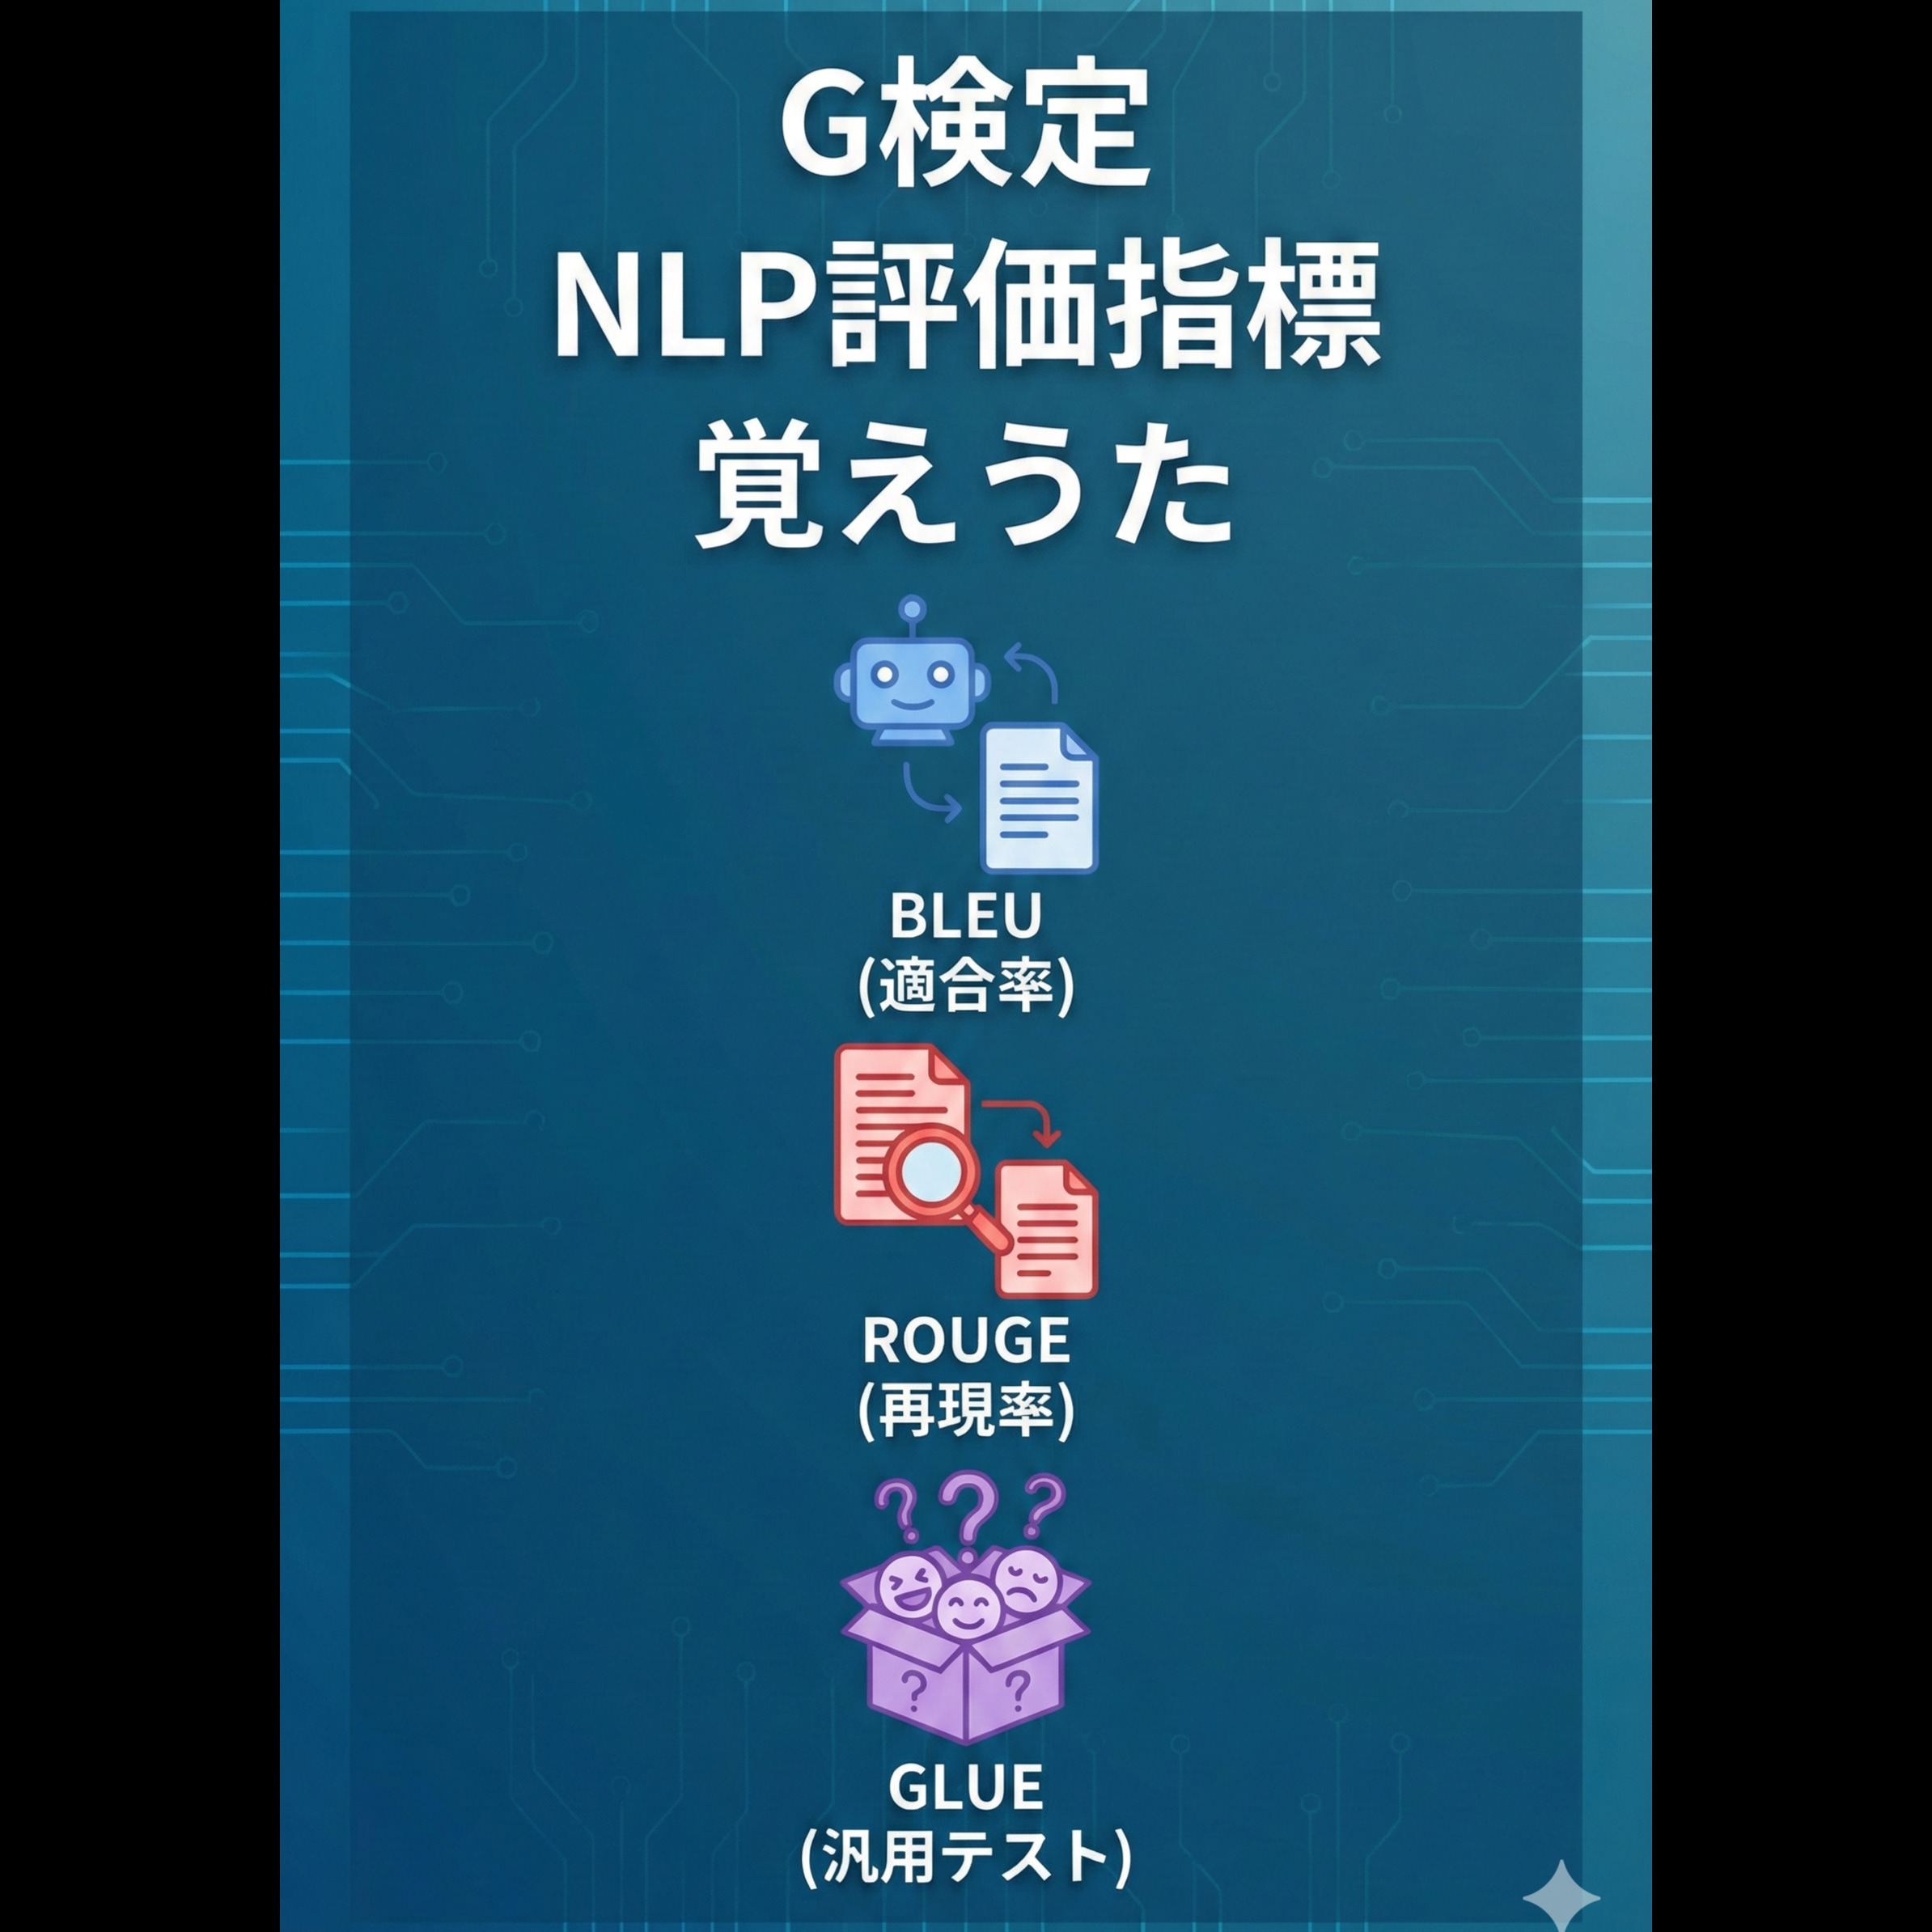
GLUEは汎用的な自然言語 理解のテスト詰め合わせ BLEUは機械翻訳の評価で 適合率重視 ROUGEは自動要約の評価で 再現率重視 GLUEは自然言語理解モデルの 汎用的な性能を 総合的に評価する ベンチマーク JGLUEはYahoo!や 早稲田大学などが 構築した日本語版のGLUE BLEUは機械翻訳の自動評価 単語の並びがどれだけ 一致しているかを測る 適合率ベース ROUGEは自動要約の 評価指標 正解データがどれだけ 網羅されているかを測る 再現率ベース BLEUは適合率 ROUGEは再現率 METEORは機械翻訳の 評価指標 完全一致だけでなく 同義語や語幹の違いまで考慮 Perplexityは言語モデルの 性能を評価する指標 単語の候補の 絞り込みやすさを表す 値が小さいほど性能が良い GLUEは汎用的な自然言語 理解のテスト詰め合わせ BLEUは機械翻訳で 適合率重視 ROUGEは自動要約で 再現率重視 METEORは 同義語や語幹も考慮 Perplexityは値が 小さいほど優秀

0/500